– Det er som vi sier: «This is the way!» Akkurat som i The Mandalorian.
Han nøler ikke, IT-direktør i Nasjonalbiblioteket Wilfred Østgulen, når han skal beskrive retningen Nasjonalbiblioteket valgte da de skulle lage norske språkmodeller.
For mens amerikanske tekgiganter skrapte (og fortsetter å skrape) internett for data først og tar rettssakene etterpå, har Nasjonalbiblioteket valgt å bygge Norges digitale fremtid på en radikalt annerledes måte.
På lovlig vis, med respekt for rettighetshaverne.
Tidligere i høst rullet de ut Borealis – verdens første nasjonale, åpne språkmodeller trent på lisensiert, opphavsrettsbeskyttet innhold hvor forfattere og mediehus faktisk får betalt.
Men å bygge AI med ren samvittighet er selvfølgelig ikke gratis.
Gjennom bevilgninger over statsbudsjettet – i første omgang 45 millioner kroner årlig for avismateriale, med et håp om titalls nye millioner på trappene for bøker så snart statsbudsjettet lander, kanaliseres pengene tilbake til opphaverne via Kopinor.
– Dette er en helt annen tilnærming, og vi har jo en tradisjon for det i Norge, sier Østgulen.
– Vi har et godt forhold til organisasjonene som representerer opphaverne. Det er slett ikke gitt at man kunne fått til noe tilsvarende i USA. Vi har presentert dette for både EU og FN, og de er veldig interesserte i en modell som respekterer rettighetshaverne.
Knekte GPT-koden sju måneder før ChatGPT
For Nasjonalbiblioteket handler dette massive løftet om noe langt dypere enn jus. Og også noe mer enn bare penger.
Historisk har biblioteket samlet den norske kulturarven i et fysisk fjellmagasin i Mo i Rana, og digitalisert den for tilgjengeliggjøring i Nettbiblioteket.
Da konseptet bak moderne språkmodeller ble kjent i 2017, skjønte AI-laben i Nasjonalbiblioteket raskt at fjellet av allerede digitaliserte norske tekster var en mulig gullgruve. De fôret modellene med norske data og fikk et enormt forsprang.
– Vi fikk det til allerede i april 2022, sier Østgulen. – Da la vi ut den aller første beta-releasen av en GPT-modell vi hadde fintrent selv på norske data. ChatGPT kom ikke før i november 2022, altså syv måneder senere.
– Oi! Men tradisjonelt har jo Nasjonalbiblioteket vært et fysisk arkiv. Nå er dere i praksis i gang med å bygge Norges digitale hjernebark?
– Ja, du har rett i det, sier Østgulen. – Tradisjonelt har vi skullet ta vare på og digitalisere alt som publiseres i den norske offentligheten. Men nå handler det ikke lenger bare om å lese verkene hver for seg. Nå handler det om å skape strukturer i disse nevrale nettverkene som faktisk representerer den norske språkkoden og den norske erfaringen.
Han ser ikke på teknologien som et brudd med fortiden, men som en videreføring av selve kjernen av hva et nasjonalbibliotek er til for.
– Når jeg nytolker samfunnsoppdraget vårt med denne teknologien i bakhodet, er dette en helt naturlig forlengelse av det oppdraget vi alltid har hatt, sier Østgulen og legger til:
– Vi er mye mer enn det store fjellmagasinet der millioner av objekter er lagret for ettertiden.
Vi er mye mer enn det store fjellmagasinet der millioner av objekter er lagret for ettertiden.
Romaner ødelegger kommafeil, men bygger kreativitet
For å finne ut om man faktisk burde bruke skattepenger på å kjøpe fri rettighetene til norske tekster, kjørte Nasjonalbiblioteket i samarbeid med Universitetet i Oslo og NorwAI ved NTNU forskningsprosjektet Mímir. De som bestilte moroa? Kultur- og Likestillingsdepartementet. Målet var å finne ut om norske data faktisk ga modellene en effekt.
– Hvis materialet ikke ga effekt, var det jo ikke noen vits i å bruke skattebetalernes penger på å kjøpe det fri, sier Østgulen. – Men hvis det ga effekt, var det nyttig for oss å vite hvilke deler av materialet som ga hvilken effekt.
Resultatet var tydelig, ifølge Østgulen.
Norske aviser og fagbøker ga en god effekt på alt som hadde med kunnskap å gjøre. Men hva med romaner, dikt og forbannet løgn?
– Vi fant ut at skjønnlitteraturen gjorde modellene litt dårligere på rene fakta. Det er jo fiksjon – det er ikke sant – og forfattere er ikke nødvendigvis så opptatt av tradisjonelle rettskrivningsregler og komma. Men det ga en boost på kreativitet og ordforråd, sier Østgulen ivrig.
Konklusjonen var klar: Norske åndsverk gjør AI-modellene markant bedre på norsk.
Amerikansk AI forstår ordet «dugnad», men ikke hvordan det føles
Og at en språkmodell skal bli god på akkurat norsk, er hele poenget som ligger bak arbeidet med å utvikle egne, norske modeller. Hvorfor? I bunn og grunn koker hele spørsmålet ned til hva slags verdier vi ønsker å bygge fremtidens forvaltning og næringsliv på. Altså her til lands.
– Du snakker om å skape stier i det nevrale nettverket. At man på en måte bygger inn strukturer som sikrer at den norske erfaringen – og måten vi gjør og sier ting på – faktisk blir tatt vare på der inne. En amerikansk AI forstår kanskje ordet dugnad, men mangler den konteksten som er nødvendig for å faktisk forstå betydningen?
– Selve praksisen, ja! Den norske praksisen knyttet til hva dugnad faktisk er, sier Østgulen. – Det er jo nettopp det vi prøver å få til. I de store amerikanske modellene er det lite vi kan gjøre, for de er lukkede systemer. Men med våre mindre modeller har vi en stor tro på at vi kan utgjøre en forskjell. De krever lite regnekraft, kan kjøre på enkel infrastruktur og ikke minst lokalt, slik at dataene dine forblir hos deg.
Språkmodeller skal skrive klarspråk, ikke beregne foreldrepengene dine
Akkurat det å ha muligheten til å kjøre modellene lokalt og målrettet er avgjørende når teknologien skal ut av laben og inn i den norske virkeligheten.
Eller sagt på en annen måte: Når de norske språkmodellene skal ut i arbeids- og næringslivet. Østgulen mener altfor mange misforstår hva en språkmodell faktisk er skapt for å gjøre.
– Våre modeller skal ikke være kunnskapsmodeller som kan svare på alt mellom himmel og jord, sier han. – De skal ikke lage en plan for maratontrening for deg, men de skal kunne oppsummere en norsk tekst, ekstrahere entiteter fra norske tekster og skrive et godt, norsk utkast eller lette journalnotater hos en fastlege. Det er språkoppgaver de skal løse.
Østgulen sier at de for eksempel skal kunne lese en søknadstekst skrevet i Word, ta en titt på trygdeloven og se om søknaden matcher kriteriene – og så skrive et utkast av svaret til en saksbehandler. I et norsk klarspråk som NAV liker.
– Men de skal ikke beregne summen på foreldrepenge-utbetalingen! sier Østgulen og smiler. – Det krever presise oppslag i databaser. Det er vanlig aritmetikk, og det er ikke språkmodeller noe gode på.
De skal ikke beregne summen på foreldrepenge-utbetalingen. Det er vanlig aritmetikk, og det er ikke språkmodeller noe gode på.
Anthropic er geniale på koding, ubrukelige på NAV-regler
– Hvorfor klarer amerikanske Anthropic å lage en enormt god løsning for koding? Jo, fordi de har tusenvis av utviklere ansatt. Klarer de å lage en god løsning for arbeidsavklaringspenger i Norge? Nei, antageligvis ikke, sier Østgulen.
– Og det er her mange norske virksomheter går i fella?
– Ja, kanskje ikke i fella, men inntil nå har vi typisk bare «boltet» modellene fast på utsiden av de gamle systemene våre, sier Østgulen. – Vi har stripset dem fast med gaffateip, rett og slett, og så sender vi bare prompter fram og tilbake via API-er. Det fungerer for å gjøre noen raske eksperimenter, men det fungerer ikke i lengden.
Løsningen? Å droppe gaffateipen.
– Ja, vi må lære oss å bygge AI-native IT-systemer, ikke bare teipe på utsiden av det utdaterte utstyret vi har liggende.
Laster ned modellene for å beholde «av-bryteren» i Norge
Østgulen er imidlertid en realist. Han erkjenner at 100 prosent digital suverenitet er en utopi i dagens teknologiske landskap.
– Vi er uansett avhengig av å trene modellene på prosessorer som er amerikanske, om det er AMD eller Nvidia, sier han. – Så vi havner jo fort nede i en avhengighet hvor vi ikke er helt nasjonalt suverene uansett.
Men nettopp fordi hardwaren ligger i hendene på de globale gigantene, mener han det er avgjørende å ta kontroll over det Norge faktisk kan styre: Softwaren, dataene og arkitekturen.
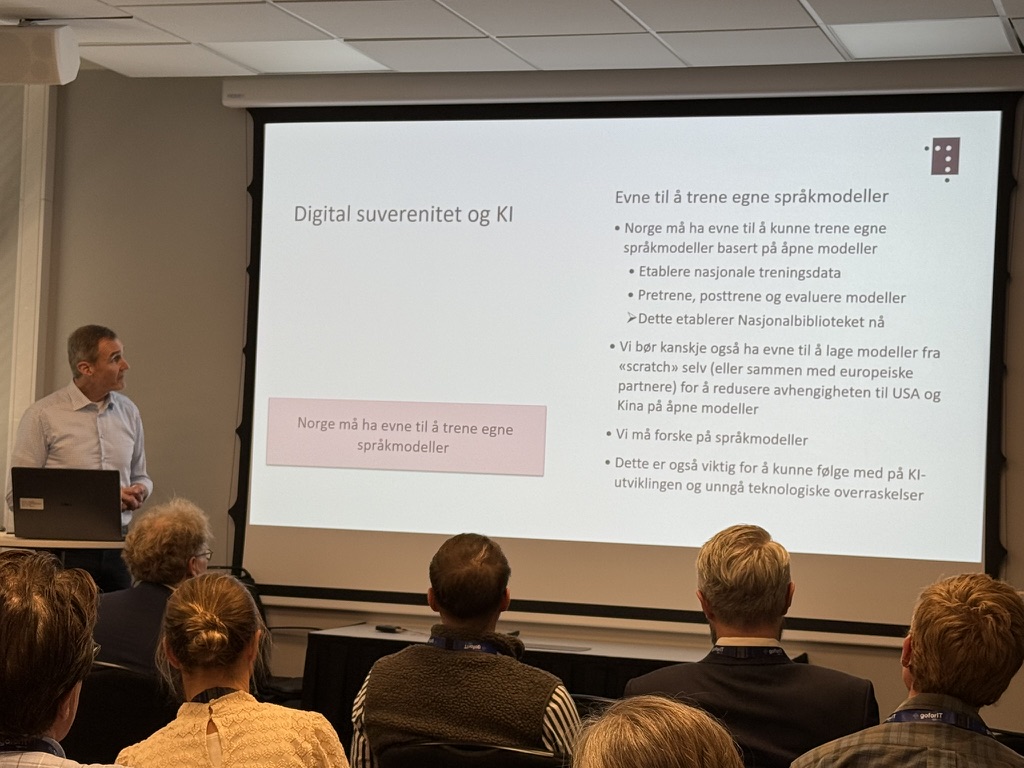
– Man laster ned modellene fra Hugging Face, sånn at man ikke risikerer at noen i utlandet plutselig trykker på av-knappen?
– Nettopp! Når vi laster ned modellen og kjører den på vår egen server i datasenteret vårt i Mo i Rana, er det ingen som får skrudd den av, sier Østgulen og legger til:
Når vi laster ned modellen og kjører den på vår egen server i Mo i Rana, er det ingen som får skrudd den av.
Wilfred Østgulen IT-direktør, Nasjonalbiblioteket
– «Software as a Service» kjører jo på en server der vi ikke har kontroll på noe som helst. Der kan de skru av Office- og Google-tjenestene våre når som helst, for det er de som bestemmer. Men den modellen vi har lastet ned og kjører på egen maskin, den får de ikke tak i.
Han tar en kort pause.
– På den måten gir denne teknologien oss en mulighet for nasjonal suverenitet som faktisk har blitt mer og mer borte i software-verdenen.
For å ta i bruk Nasjonalbibliotekets åpne, norske språkmodeller kreves en strategisk tilnærming til IT-arkitekturen:
Sagaen om AI i Norge skrives nå
For Østgulen er håpet at lanseringen av Borealis blir stående som en teknologisk milepæl i Norge. Det er iallfall det han sier når han blir bedt om å spole frem til 2030 og kikke tilbake på lanseringen av de norske språkmodellene.
– Jeg har sagt det noen ganger: Når sagaen om da AI kom til Norge skal skrives, kommer de som jobber på Nasjonalbiblioteket til å bli nevnt, sier Østgulen og smiler.
– Nå skal plutselig maskiner vurdere om en modell er «god på norsk» og om den oppfører seg i tråd med norske verdier. Det har vi filosofert og skrevet mye om opp gjennom historien, men vi har aldri gjort det computational. Det bygger vi infrastrukturen for nå.
For at infrastrukturen faktisk skal skape verdi, må norske virksomheter begynne å bygge på toppen av den. Østgulen er tydelig på at Nasjonalbiblioteket skal levere byggeklossene, men de har ingen planer om å bli et konsulenthus.
Han er ikke i tvil om at ballen ligger hos det norske næringslivet og offentlige virksomheter. Og litt hos Nasjonalbiblioteket for å spre det viktige budskapet.
– Vi må ut og samarbeide med virksomhetene. Den store jobben vår videre blir å hjelpe andre med å ta i bruk modellene. Vi kommer blant annet til å samarbeide med KI Norge, Digital Norway, Digdir og Helsedirektoratet.
– Norske virksomheter bør kjenne sin besøkelsestid og logge seg inn på Hugging Face?
– Ja! Og vi i Nasjonalbiblioteket bør kjenne vår besøkelsestid og knytte tettere bånd til norske virksomheter. Frem til nå har AI-kappløpet vært teknologidrevet. Nå er det på tide at det blir brukerdrevet.